Mac mini M4 Pro(24GB)とRTX 2070 SUPER(8GB)、同じローカルLLMはどちらが速いか — qwen3 8B/14B/32Bで実測
同じqwen3を同じOllama・同じ質問で、Mac mini M4 Pro(24GB)とRTX 2070 SUPER(8GB)に流して実測。8Bは2070 SUPERが66.82対43.88で速く、14BはMacが24.97対7.6で逆転した。境目はVRAMに載るかどうか。
VRAMに全部載る8Bでは、RTX 2070 SUPERが66.82トークン/秒でMac miniの43.88より速かった。14Bでは逆転し、Macが24.97、2070 SUPERは7.6。分かれ目は「モデルがVRAM 8GBに収まるか」だった。
俺の開発環境は二刀流だ。Mac mini(M4 Pro)で書いて、型落ちのRTX 2070 SUPER機を重機として回す。
ではローカルLLMはどちらで動かすのが速いのか。GPUを積んだWindows機か、メモリの大きいMacか。同じOllama・同じモデル・同じ質問で、2台を測った。各機1台・1条件での測定で、環境が違えば結果は変わる。
測った条件。同じOllama、同じモデル、同じ質問
2台の違いは、モデルを置く場所の大きさにある。
RTX 2070 SUPERのメモリは公称8GB GDDR6・256-bitで、アーキテクチャはTuringだ(出典: NVIDIA GeForce RTX 20シリーズ比較)。Mac mini(2024)のM4 Proは、標準構成のユニファイドメモリが24GB、メモリ帯域幅は公称273GB/sとされている(出典: Apple Mac mini (2024) 技術仕様)。ユニファイドメモリはCPUとGPUが同じメモリを使う仕組みで、OllamaはApple製品のGPUをMetal経由で使う(出典: Ollama GPU)。
現場でいえば、搬入口は狭いが重機が強い現場と、搬入口が広い現場に、同じ資材を3サイズ入れてみた形だ。
| 項目 | RTX 2070 SUPER機 | Mac mini |
|---|---|---|
| 構成 | i7-9700K / RTX 2070 SUPER(VRAM 8GB)/ DDR4 16GB / Windows 11 Home | Apple M4 Pro / ユニファイドメモリ24GB / macOS 27.0 |
| ドライバー | NVIDIA 617.14 | — |
| Ollama | 0.34.4 | 0.34.4 |
| モデル | qwen3:8b / 14b / 32b(いずれも q4_K_M) | 同じ |
| 生成設定 | temperature 0・seed 42・num_predict 256・num_ctx 4096・思考モードなし | 同じ |
| 回数 | 読み込み込みの1回目のあと3回、中央値を採用 | 同じ |
| 32Bの例外 | num_predict 32(1回のみ) | 同じ |
| 測定日 | 2026年9月28日 | 2026年9月28日 |
質問は全モデル共通で「ローカルLLMを動かすときのVRAMの役割を、パソコン初心者向けに300字程度で説明してください。」にした。
速さはOllamaが返す eval_count(出力トークン数)÷ eval_duration(生成時間)だ(出典: Ollama API generate)。2台とも普段の作業状態のまま測った。Macはブラウザなどを開いたまま、Windowsも常駐アプリが残っている。
32Bだけ条件が違う。最初に256トークンで測ろうとしたら、2070 SUPER機は30分を超えても終わらなかった。そこで32Bは32トークンの短い生成に切り替えた。
結果。8Bは2070 SUPER、14BはMacが速い
中央値をそのまま並べる。
| モデル | 2070 SUPER 生成速度 | GPU側 | Mac mini 生成速度 | GPU側 |
|---|---|---|---|---|
| qwen3:8b-q4_K_M | 66.82 tok/s | 100% | 43.88 tok/s | 100% |
| qwen3:14b-q4_K_M | 7.6 tok/s | 63% | 24.97 tok/s | 100% |
| qwen3:32b-q4_K_M | 0.02 tok/s | 29% | 0.07 tok/s | 82% |
「GPU側」は、読み込んだモデルのうちGPUが使うメモリに載った割合だ。Ollamaの /api/ps が返す size と size_vram から出している。
8Bは2台ともGPU側100%で、2070 SUPERのほうが約1.5倍速かった(66.82÷43.88)。
14Bで順位が入れ替わる。2070 SUPERはモデルの63%しかVRAMに載らず、7.6トークン/秒まで落ちた。Macは100%載ったままで24.97トークン/秒。差は約3.3倍だ(24.97÷7.6)。
3回のばらつきは小さかった。
| モデル | 2070 SUPER(3回) | Mac mini(3回) |
|---|---|---|
| 8B | 66.9 / 66.74 / 66.82 | 43.94 / 43.87 / 43.88 |
| 14B | 7.58 / 7.61 / 7.6 | 24.99 / 24.97 / 24.94 |
同じ質問を2台に同時に投げた録画
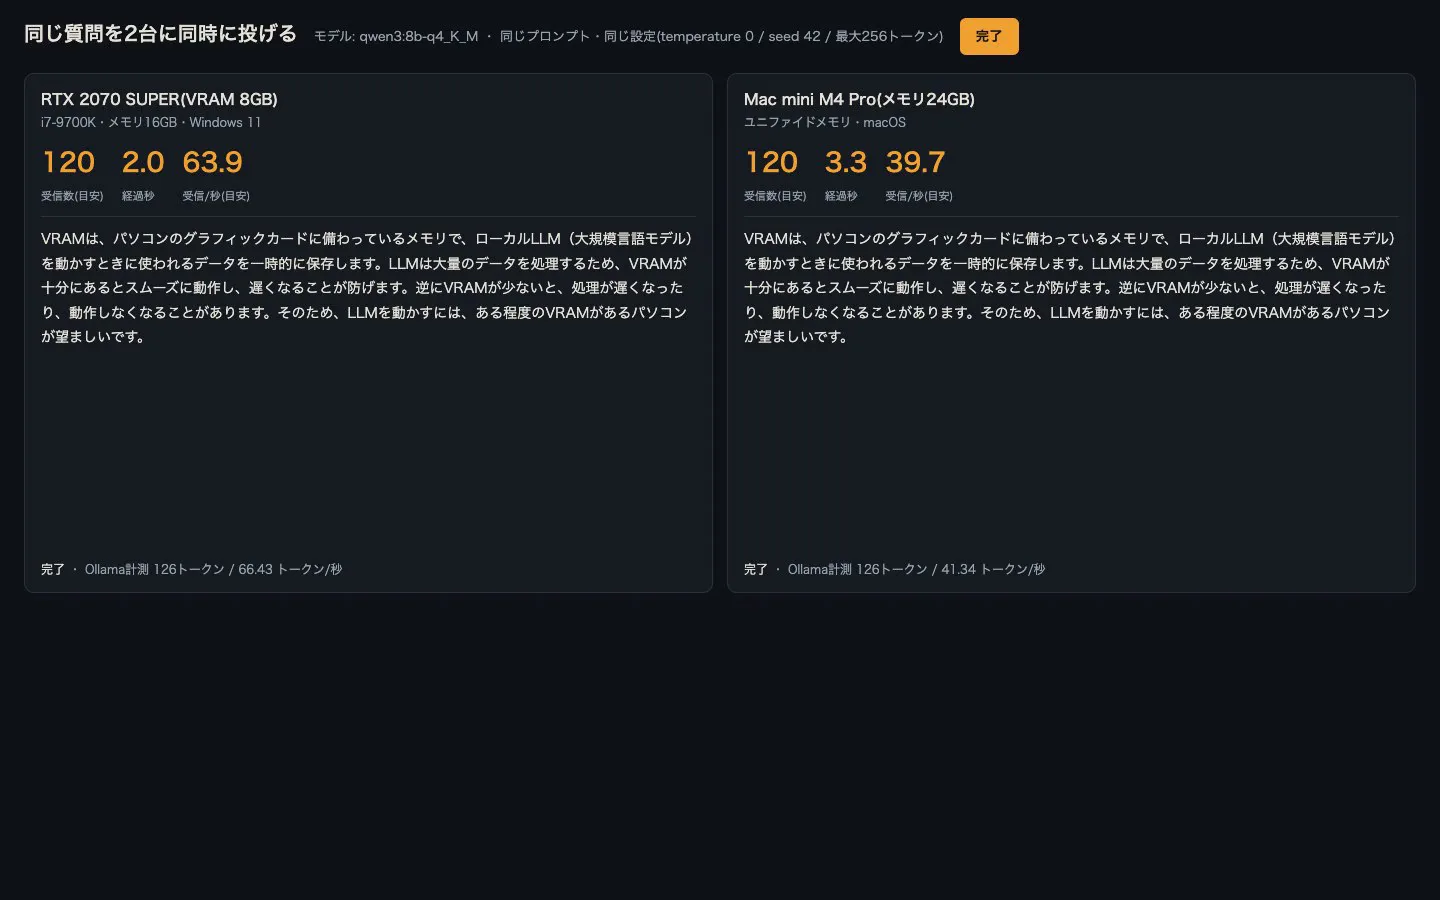
数字だけだと差の大きさがつかみにくい。同じ質問・同じ設定を2台へ同時に送り、ブラウザの画面を実時間で録画した。左が2070 SUPER、右がMac miniだ。
14Bになると、見え方が逆になる。
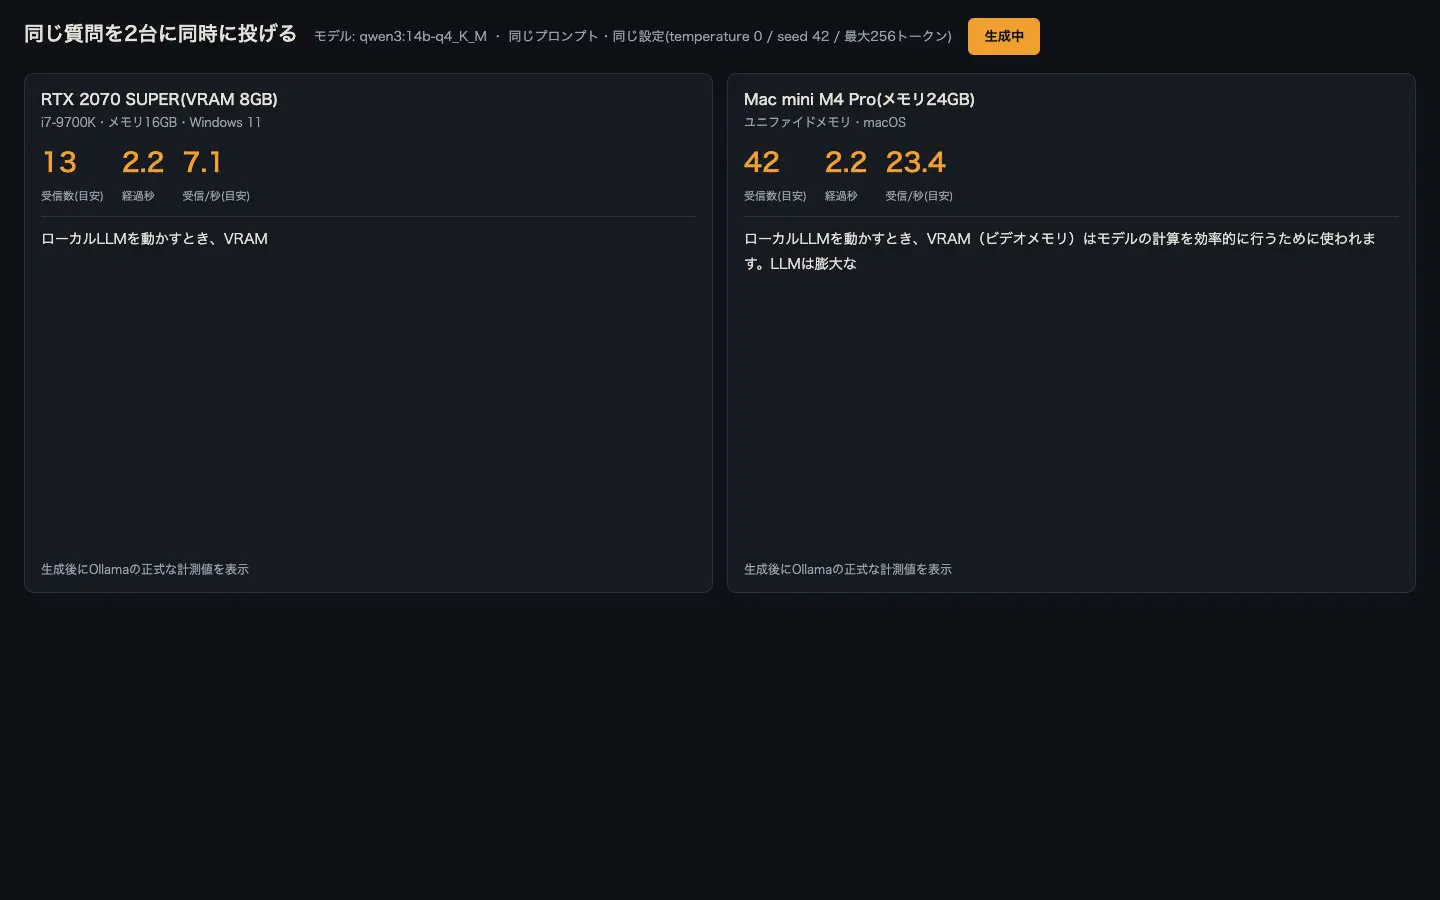
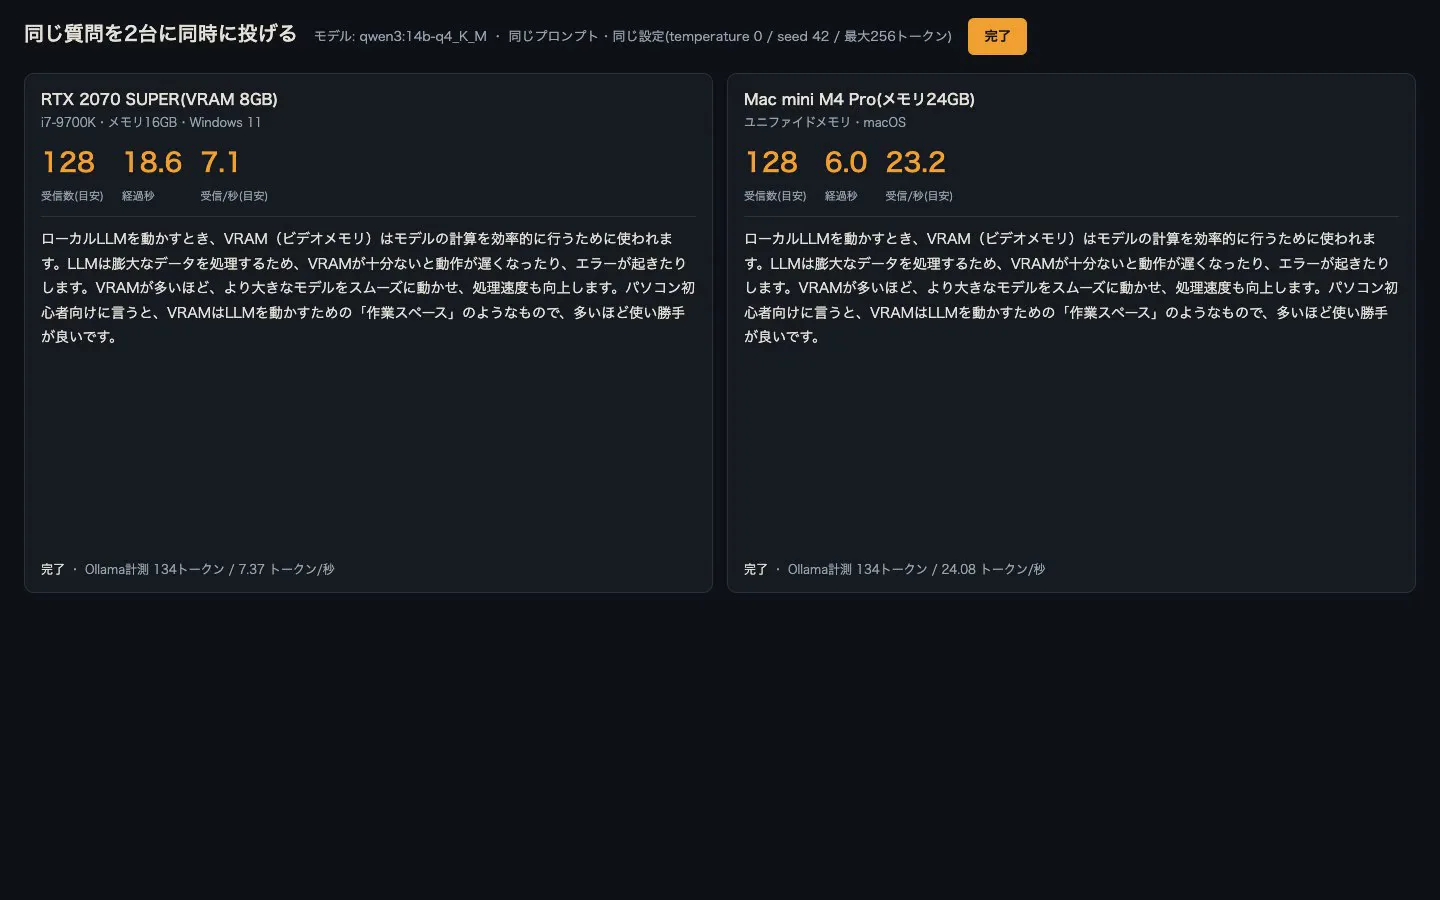
8Bでは左が先に書き終わり、14Bでは右が先に書き終わる。同じ文章を出しているので、違うのは速さだけだ。
逆転の境目は「VRAM 8GBに収まるか」
8Bは読み込み時のモデルが5.58GBで、8GBのVRAMに全部載った。14Bは10.15GBで、VRAM側は6.35GBで止まった。
あふれた残りはメインメモリ側に置かれる。2070 SUPER機の読み込み中のGPU使用率は、8Bで96%、14Bで13%だった。VRAMの外の計算を待って、GPUが手待ちになっていると読める。ただしこれは記録した数値からの推測で、内部の処理までは測っていない。
Macの14Bは10.07GBで、全部GPU側に載った。ユニファイドメモリ24GBの枠には、14Bがまだ収まる。
つまり今回の3点で言えるのは、交差点が8Bと14Bの間にあるということだ。その間のサイズ(たとえば別の量子化やモデル)は測っていないので、正確な境目は分からない。
手元のモデルがどちら側にいるかは、ollama ps で確かめられる。公式FAQによると、PROCESSOR欄が「100% GPU」なら全部GPU、「48%/52% CPU/GPU」のような表示なら両方に分かれている(出典: Ollama FAQ)。今回の14Bでは、「100% GPU」が崩れた側が遅くなった。
32Bは2台とも「動くが使えない」
32Bは、どちらの機械でも1トークン/秒を大きく下回った。
| 機械 | GPU側に載った量 | 生成速度 | 32トークンにかかった全体の時間 | 読み込み中のメモリ |
|---|---|---|---|---|
| 2070 SUPER | 6.35/21.56GB(29%) | 0.02 tok/s | 1,818.03秒 | 空き15MiB/16,305MiB・ページファイル3,939MiB |
| Mac mini | 17.76/21.66GB(82%) | 0.07 tok/s | 539.77秒 | 空き3%・スワップ使用10,500.56MB |
MacはGPU側に82%載ったが、それでも0.07トークン/秒だった。読み込み中のメモリの空きは3%まで減り、スワップ(ディスク上の仮のメモリ)の使用は10,500.56MBだった。24GBからOSと開いていたアプリの分を引くと、21.66GBのモデルは置ききれなかったと読める(推測)。
2070 SUPER機は、メインメモリの空きが15MiBまで減った。VRAM 8GBとメモリ16GBを足しても、22GBの資材を置く場所がない。
条件を直す前の1回目も記録が残っている。256トークンで測ったとき、Macは121トークンに1,294.5秒かかり、2070 SUPER機は30分のタイムアウトを超えて終わらなかった。
24GBのMacでも、32Bのq4_K_Mは普段使いの速さにならなかった。ブラウザなどを閉じれば変わる可能性はあるが、その条件は測っていない。
読み込みと応答の時間。体感に近い数字
生成速度だけでなく、待ち時間も記録した。
| モデル | 1回目の読み込み 2070 SUPER | 1回目の読み込み Mac | 2回目以降の応答全体 2070 SUPER | 2回目以降の応答全体 Mac |
|---|---|---|---|---|
| 8B | 14.24秒 | 3.06秒 | 1.91〜1.95秒(126トークン) | 2.9秒(126トークン) |
| 14B | 25.16秒 | 4.82秒 | 14.73〜14.83秒(111トークン) | 5.41〜5.42秒(134トークン) |
| 32B | 83.89秒 | 41.73秒 | — | — |
最初の読み込みは、どのサイズでもMacのほうが短かった。2070 SUPER機のモデル置き場はSATA SSD(G:)だ。置き場で読み込み時間がどう変わるかは、別に測っている。
プロンプト(51トークン)を読む速さも出ている。8Bは2070 SUPERが3070.4〜3202.7、Macが2169.8〜2171.8トークン/秒。14Bは2070 SUPERが379.1〜382.6、Macが1261.2〜1263.3トークン/秒だった。今回のプロンプトは51トークンと短く、長い資料を読ませたときの比較はしていない。
なお14Bでは、同じ設定でも出力トークン数が2台で違った(2070 SUPER 111、Mac 134)。応答全体の秒数は、この違いも含んだ値だ。
二刀流の分担。8Bは重機へ、14BはMacで
測った範囲で、俺の環境の分担はこう決まる。
- VRAM 8GBに全部載るサイズ(今回の8B)は、2070 SUPER機のほうが速い。66.82対43.88トークン/秒
- VRAMからあふれるサイズ(今回の14B)は、Mac miniのほうが速い。24.97対7.6トークン/秒
- 32Bのq4_K_Mは、どちらでも0.1トークン/秒未満。この2台では実用の外
段取り八分でいえば、モデルのサイズを見てから、どの現場に回すかを決める。MacからWindows機へ仕事を投げる経路はMac miniとWindows機をつなぐ設計図にまとめた。2070 SUPER側であふれたときの細かい挙動はOllamaのVRAMあふれ実測、VRAM別に載るモデルの目安はローカルLLMのPCスペック早見表にある。
14B以上をGPUの速さで回したいなら、VRAMの枠を広げる話になる。今週のセール機をVRAM基準で仕分けた表と二刀流ランキングを置いておく。
最強の1台より、載せたいモデルが「100% GPU」になる枠。この1点を外さない分担だ。
※本記事は公開情報と筆者の手元環境(RTX 2070 SUPER機とMac mini M4 Proの各1台・2026年9月28日)での測定に基づく解説です。各モデル1条件の測定で、32Bは1回・32トークンのみです。ドライバー・Ollamaの版・常駐アプリ・空きメモリ・コンテキスト長で結果は変わります。最新の仕様は各公式ドキュメントをご確認ください。
出典
- NVIDIA GeForce RTX 20シリーズ比較(RTX 2070 SUPER 8GB GDDR6・256-bit・Turing): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/?section=compare-20
- Apple Mac mini (2024) 技術仕様(M4 Pro・ユニファイドメモリ24GB・メモリ帯域幅273GB/s): https://support.apple.com/en-us/121555
- Ollama GPU(Apple製品のMetal対応・NVIDIAの対応条件): https://docs.ollama.com/gpu
- Ollama FAQ(ollama psのPROCESSOR表示): https://docs.ollama.com/faq
- Ollama API generate(eval_count・eval_duration・num_predict・num_ctx・seed): https://docs.ollama.com/api/generate
- Ollama API ps(size・size_vram): https://docs.ollama.com/api/ps