// Mac × ゲーミングPC ハイブリッド開発要塞
開発はMac、火力はWindows。
Mac mini M4 Pro(司令塔)と型落ちRTX 2070 Super搭載ゲーミングPC(重機)の二刀流で、 AI×ゲーム開発に挑む実録ブログ。実際に動かして検証した結果だけを書く。
Sale / Best Buy
〜20万円の本命: FRONTIER FRGKB550/WS1113。提携3社の現行セール機をVRAM・メモリの二刀流基準で仕分け。毎日チェック、変化があれば当日更新。
Weekly Digest
デスクトップ版RTX Sparkの実力、ノートPC版と同条件で比較/1800億パラメータ級MoEを32GBのMacで、Transformersで専門家を逐次読み込み/PowerShell 5.1が非推奨に、次期WindowsはPowerShell 7へ。今日の3本です。
Latest Posts
 画像生成モデルのライセンスと商用利用 — SDXL・FLUX.1・SD3.5の公式記載を「本体」と「生成物」に分けて読む
SDXL base 1.0・FLUX.1 [dev]・FLUX.1 [schnell]・SD3.5 Largeの公式ライセンスとモデルカードを並べ、モデル本体を動かす条件と生成した画像を使う条件を分けて整理する。法的助言ではなく、原文の読み方の段取りをまとめた。
 中古GPU・中古ゲーミングPCを買う前に確かめること — メーカー保証は「最初の購入者」で切れる規定が多い
中古のグラフィックボードや中古ゲーミングPCに、メーカーやBTOショップの保証は引き継がれるのか。GPUメーカー・代理店・BTO各社・中古ショップの公式規定を読み、譲渡品の扱い、中古保証の期間、Windowsと処分の確認点を整理した。
 Windows 11のGPUスケジューリング(HAGS)とAI用途 — オンで何が移り、VRAM不足には何が効かないか
WindowsのHardware-accelerated GPU scheduling(HAGS)は、GPUの仕事の段取り役をCPUからGPU側へ移す設定だ。Microsoft・NVIDIAの公式説明から、何が変わるか、AIツールで見るべき別の設定はどれかを整理する。
 BTOパソコンが届いたら最初にやること — 初期不良の期限、Windows Update、ドライバー、回復キーを公式の案内で
BTOが届いた週にやることを、マウス・ドスパラ・パソコン工房の保証規定と、Microsoft・NVIDIAの公式手順で整理。初期不良の連絡期限、保証書の保管、Windows Update、GPUドライバー、BitLocker回復キーと回復ドライブの順に並べた。
 ローカルLLMのコンテキスト長とVRAM — KVキャッシュの大きさをモデル公式のconfig.jsonから計算する
ローカルLLMで文脈を伸ばすと増えるのがKVキャッシュ。公式config.jsonの層数・KVヘッド数・head_dimの3つを式に入れれば、1トークンあたりの容量と4K〜128K文脈でのVRAMが電卓で出る。Qwen3とphi-4の5モデルで計算する。
 RTX 50シリーズのVRAM一覧 — 5090/5080/5070 Ti/5070/5060 Ti/5060の容量・帯域と、AI用途の目安を公式スペックで
RTX 50シリーズのVRAMは8GB・12GB・16GB・32GBの4段。5090から5060までの容量・バス幅・帯域をNVIDIA公式の公称値で1枚の表にし、公表サイズのモデルがどの段から収まるかを整理した。5060に12GB版はない。
 VS CodeでローカルLLMのコード補完 — ContinueとOllamaをつなぐ公式手順と、クラウド型との違い
VS Code拡張のContinueとOllamaを組み合わせると、コード補完を自分のPCのGPUで回せる。公式ガイドにある導入手順、config.yamlの書き方、補完向けモデルの選び方、VRAMの足し算、クラウド型との違いを公式記載だけで整理する。
 BTOのカスタマイズで「AI開発向け」に足すもの・足さなくていいもの — メモリ・SSD・電源・CPUクーラーを大手3社の画面で仕分ける
ドスパラ・マウス・パソコン工房のカスタマイズ画面を2026-10-31に読み、メモリ・電源・SSD・CPUクーラーの選択肢と差額を並べた。注文時に足しておくものと、後回しでいいものを、NVIDIA公称の必要電力と各社の保証の扱いから仕分ける。
 7年前のLEVEL∞(i7-9700K/RTX 2070 SUPER/メモリ16GB)でローカルAIはどこまで動くか — 実測5本の総まとめと買い替え判断
パソコン工房のBTO・LEVEL∞(RTX 2070 SUPER 8GB)で測った5本の実測をまとめた。SDXLは2048まで完走、qwen3 8Bは66.82トークン/秒。崩れたのは14B以上のLLMだけで、買い替えの判断軸はVRAM 8GBの枠に絞られた。
 Mac mini M4 Pro(24GB)とRTX 2070 SUPER(8GB)、同じローカルLLMはどちらが速いか — qwen3 8B/14B/32Bで実測
同じqwen3を同じOllama・同じ質問で、Mac mini M4 Pro(24GB)とRTX 2070 SUPER(8GB)に流して実測。8Bは2070 SUPERが66.82対43.88で速く、14BはMacが24.97対7.6で逆転した。境目はVRAMに載るかどうか。
 モデル置き場で読み込み時間は変わるか — NVMe・SATA SSD・HDDに同じSDXLを置いて実測
同じSDXLモデル(6.94GB)をNVMe・SATA SSD2台・HDDに置き、キャッシュなしの読み込み時間とComfyUIの最初の1枚を実測。2枚目がそろう理由と、ComfyUIのfast_disk判定、HDDで困らない場面を整理する。
 RTX 2070 SUPERの消費電力をnvidia-smiで実測 — SDXL生成・ローカルLLM・アイドルでGPUは何W使うか
RTX 2070 SUPER機のGPUボード電力をnvidia-smiで0.5秒ごとに記録。アイドル46.8W、SDXLは1枚0.906Wh、qwen3 8B生成は平均193.0W、VRAMからあふれた14Bは61.0Wだった。31円/kWhでGPU分の電気代も出す。
 AI生成の電気代の目安 — GPUの公称電力×時間×単価31円で上限を出す計算式
画像生成やローカルLLMの電気代は「GPUの公称電力(W)÷1000×時間×電気料金単価」で上限側の目安が出せる。RTX 5060〜5090のNVIDIA公称値と家電公取協の目安単価31円/kWhで1時間・1か月の金額を計算し、実際の電力の確かめ方まで整理する。
 NVIDIAドライバーとCUDAのバージョンの関係 — 公式の互換表で、AIツールが動かないときの確認順
nvidia-smiに出るCUDAの版は「入っている版」ではなく「動かせる上限」だ。NVIDIA公式の互換表とPyTorch・ComfyUI・Ollamaの公式記載から、ドライバー・CUDA・GPU世代の関係と、AIツールが動かないときに見る順番を整理する。
 画像生成UIの違い — ComfyUI・Forge・AUTOMATIC1111を公式の対応モデル・更新状況・導入方法で比べる
画像生成のローカルUIの定番、ComfyUI・Forge・AUTOMATIC1111。系統の違い、公式の対応モデル、各リポジトリの最終更新日、Windowsでの導入方法を一次情報だけで並べ、今から入れるならどれかを整理する。
 LM Studioの導入手順(Windows) — 公式の動作要件・モデルの置き場・GPUオフロード・ローカルサーバーまで
LM Studioは、ローカルLLMを画面操作で落として動かせる無料アプリだ。Windowsの公式動作要件、Discoverでの入手、モデルの置き場、GPUオフロードとコンテキスト長、ローカルサーバーとlms CLIを公式ドキュメントだけで整理する。
 LM StudioとOllama、同じGPU・同じモデルファイルなら速さはどれだけ違うか — RTX 2070 SUPERで実測
RTX 2070 SUPER(VRAM 8GB)で、OllamaとLM Studioに完全に同じGGUF(qwen3 8B Q4_K_M)を読ませて5回ずつ実測。Ollama 67.54、LM Studio 64.58トークン/秒で差は約4.4%。測り方と録画も載せる。
 量子化(Q4・Q8・FP16)とVRAM — ローカルLLMの必要容量を公式のモデル表とKVキャッシュの式で計算する
ローカルLLMの必要VRAMは「重み(量子化で決まる)+KVキャッシュ(文脈の長さで決まる)」の足し算。llama.cppの量子化別サイズ表、モデル設定の層数・ヘッド数、Ollamaの設定項目から、8GB・12GB・16GBで何が載るかを電卓で出す。
 ゲーミングノート(RTX 50 Laptop)でAI開発 — 同じ名前のGPUでもVRAM・電力・メモリ増設がデスクトップと違う
RTX 50シリーズのLaptop GPUとデスクトップ版をNVIDIA公式の公称値で比較。5070 Tiは16GBが12GBに、5070は12GBが8GBになる。電力の幅とメモリ増設の可否もメーカー公式仕様で確かめ、AI開発でノートを選ぶときの見方を整理。
 AI開発用PCのCPU選び — RyzenとCore Ultra、メモリ上限・PCIeレーン・NPUを公式仕様で並べる
ローカルAIの主役はGPUで、CPUは「道の本数」と「あふれた分の置き場」を決める部品だ。Ryzen 7 9700X/9800X3D・8700GとCore Ultra 7 265K/9 285Kの公式仕様から、メモリ上限・PCIeレーン・NPUの位置づけを整理した。
 RadeonでローカルAIは使えるか — RX 9070 XTとROCm・Vulkan・DirectML、Ollama/ComfyUIの公式対応を仕分ける
RX 9070 XT(16GB)でOllamaとComfyUIは動くのか。AMDのROCm互換表、Ollama GPUドキュメント、ComfyUI README、DirectMLの現状を読み、WindowsとLinuxで通れる道を公式記載の範囲で整理した。
 RTX 5080 vs RTX 5090 — VRAM 16GBと32GB、AI用途で32GBが要る場面を公式スペックで仕分ける
RTX 5080は16GB、RTX 5090は32GB。NVIDIA公式の公称値と、Ollama・FLUX.1の公表サイズから「5090でだけ収まるモデル」の帯を割り出す。帯域・電力・BTO実売の差も並べ、32GBに払う意味がある人を整理した。
 ローカルAI実行中のGPU使用状況の確かめ方 — nvidia-smiのVRAM・使用率の読み方を実測ログで
ローカルAI実行中のGPUの様子は nvidia-smi で読める。RTX 2070 SUPER(8GB)でSDXLとOllamaを動かした実測ログを材料に、VRAM使用量・GPU使用率・電力の読み方と、1秒ごとに記録するコマンドを公式ドキュメントどおりに整理する。
 RTX 5060 Ti 16GB vs RTX 5070 12GB — AI用途はVRAM容量か速度か、公式スペックで仕分ける
RTX 5060 Ti 16GBとRTX 5070 12GBをNVIDIA公式の公称値で比較。VRAMは5060 Tiが4GB多く、帯域とCUDAコアは5070が上。12GBと16GBの間に落ちるモデルを使うかどうかで選ぶ基準と、8GB版との取り違えの注意点を整理。
 OllamaのモデルがVRAMからあふれると何が起きるか — RTX 2070 SUPER 8GBでqwen3 8B/14B/32Bを実測
RTX 2070 SUPER(VRAM 8GB)のOllamaでqwen3の8B・14B・32Bを実測。全部載る8Bは66.82トークン/秒、37%があふれた14Bは7.6、32Bは0.02。ollama psの読み方とOLLAMA_MODELSの公式手順も整理する。
 VRAM 8GBでSDXLはどこまで動くか — RTX 2070 SUPERで --lowvram・fp8・解像度・枚数を実測
RTX 2070 SUPER(VRAM 8GB)のComfyUIでSDXLを、既定・--lowvram・fp8の3モード×解像度・枚数の12条件で実測。全条件でエラーなく完走した結果と、--lowvramで差が出なかった理由を公式情報で整理する。
 マウス・パソコン工房・ドスパラを横並びで比べる — AI開発もやる人が大手BTO3社で見るべき5項目
国内BTOの大手3社、マウスコンピューター・パソコン工房・ドスパラを公式情報だけで横並び比較。保証と延長の料金、送料・納期、店舗サポート、メモリ上限とカスタマイズ、自分で増設したときの保証の扱いを、ローカルAIもやる人の目線で整理した。
 ドスパラ(GALLERIA)をAI開発目線で読む — 翌日出荷の条件と、1年保証をどう補うか
ドスパラのゲーミングPC「GALLERIA」を、ローカルLLMや画像生成もやる人の目線で公式情報から整理。新しいX/S/F/Eシリーズ、VRAM 12GB以上の現行モデル、カスタマイズの幅、翌日出荷の条件、1年保証と延長保証・セーフティサービスの違いをまとめた。
 マウスコンピューター(G TUNE・NEXTGEAR・DAIV)をAI開発目線で読む — 3年保証の中身と、メモリ上限で決まるシリーズ選び
マウスコンピューターのゲーミングPCを、ローカルLLMや画像生成もやる人の目線で公式情報から整理。G TUNE・NEXTGEAR・DAIVの違い、VRAM 12GB以上の現行モデル、シリーズで決まるメモリ上限、標準3年保証と自分で増設したときの扱いをまとめた。
 パソコン工房(LEVEL∞)をAI開発目線で読む — GPUは型番で選び、メモリと電源はカスタマイズで足す
パソコン工房のゲーミングPC「LEVEL∞」を、ローカルLLMや画像生成もやる人の目線で公式情報から整理。VRAM 12GB以上の現行モデル、カスタマイズで変えられる部位と変えられない部位、保証・延長保証の料率、店舗サポートと送料・納期をまとめた。
 ComfyUIポータブル版にManagerを入れる手順 — v0.37.0で有効化し、スナップショットで戻せる状態にするまで
ComfyUIポータブル版v0.37.0にComfyUI-Manager 4.2.2を公式手順で入れ、--enable-managerで起動してスナップショットを保存するまでを、RTX 2070 SUPER機の実行記録と公式情報で整理する。
 ローカルLLMをブラウザで使う — Open WebUIとOllamaをつなぐ公式手順(Docker/pip)と、つながらない時のポート整理
Open WebUIを入れると、Ollamaで動かすローカルLLMをChatGPT風の画面で使える。Docker・pipの公式コマンド、Ollamaとの接続先URL、3000/8080/11434の関係、更新とバックアップの手順を公式ドキュメントだけで整理する。
 RTX 5070 Ti vs RTX 5080 — 同じVRAM 16GBで何が違う? AI開発視点で公式スペックを比較
RTX 5070 TiとRTX 5080はどちらもVRAM 16GB。NVIDIA公式の公称値で、帯域・CUDAコア・AI TOPS・電力の差と、ローカルLLMや画像生成で「載るモデルは同じ」理由を整理。BTO実売の差額12.5万円の考え方も。
 自作とBTO、総額はどこで差がつくか — 公式に金額が書いてある項目だけを積む
自作PCとBTOの総額差を、日々動くパーツ実売価格ではなく公式に公表されている項目だけで比べる。Windowsのライセンス代、BTOの送料と延長保証の料率、CPUやバルク品の保証期間、処分時の回収費用を公式記載ベースで整理した。
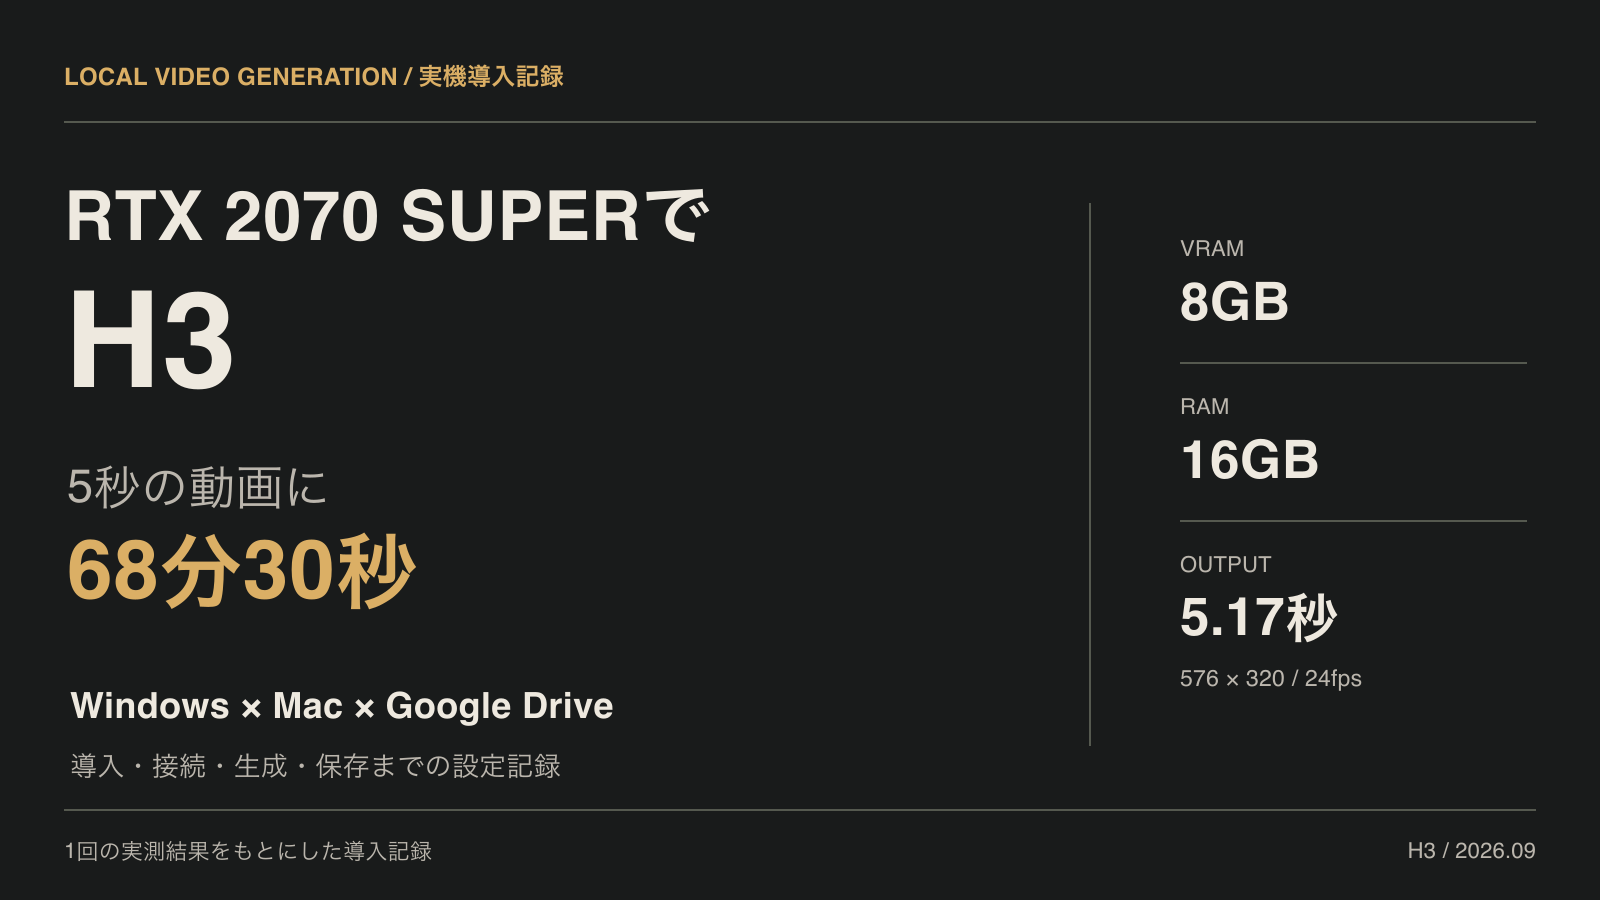 5秒の動画に68分30秒。RTX 2070 SUPERでMiniMax H3を動かした記録
RTX 2070 SUPER 8GB・RAM 16GBのWindowsで、MiniMax H3の約5秒動画を生成。MacからTailscale経由でSSH操作し、Google Driveへ素材を集める構成と、導入時の失敗・実測時間・未検証の範囲を記録する。
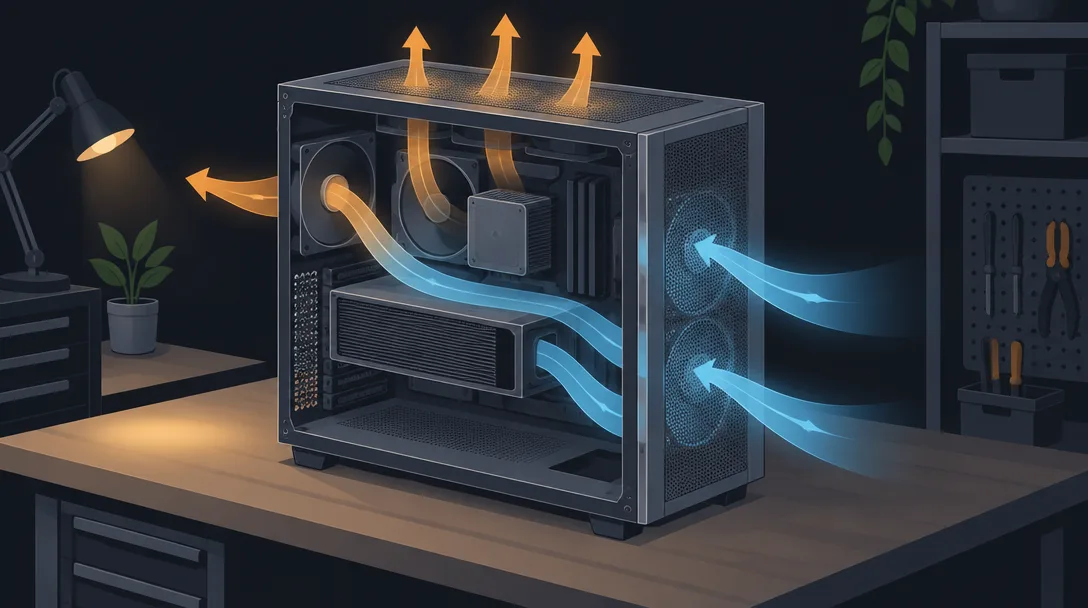 PCケースとエアフローの基本 — GPU長・電源の位置・吸気と排気の向きを公式仕様で読む
ケース選びで先に見るのは「最大GPU長」「電源の位置」「ファンの吸排気の向き」の3点。CORSAIR・NZXT・NVIDIA・ドスパラの公式仕様と公式解説だけで、ケース仕様表の読み方と正圧・負圧の考え方を整理する。
 モニター選びはGPUの仕事量から逆算する — 解像度・リフレッシュレート・端子の確認手順
モニターの解像度とリフレッシュレートは、GPUが1秒に描く画素の量を決める。フルHD・WQHD・4Kの画素数の差、Hzごとの1フレームの持ち時間、RTX 50シリーズの公式出力仕様、G-SYNCとWindows設定の確認手順を一次情報で整理する。
 SSD増設の選び方|NVMe Gen4・Gen5とAIモデル置き場の容量計算
ゲーミングPCのSSD増設は、NVMeの世代だけでなく空きM.2スロットと接続条件の確認から。Gen4・Gen5の違い、AIモデルの容量計算、Ollama・ComfyUIの保存先設定を公式資料から整理。増設前に読む手順もまとめる。
 ComfyUIの導入手順 — WindowsゲーミングPCにポータブル版/WSL2で入れて、fp8でVRAMを節約するまで
ComfyUIはポータブル版を展開してrun_nvidia_gpu.batを押せばブラウザで起動する。Desktop・ポータブル・WSL2の3ルート、CUDA 13.0とドライバ580の条件、fp8モデルと起動オプションを公式情報で整理する。
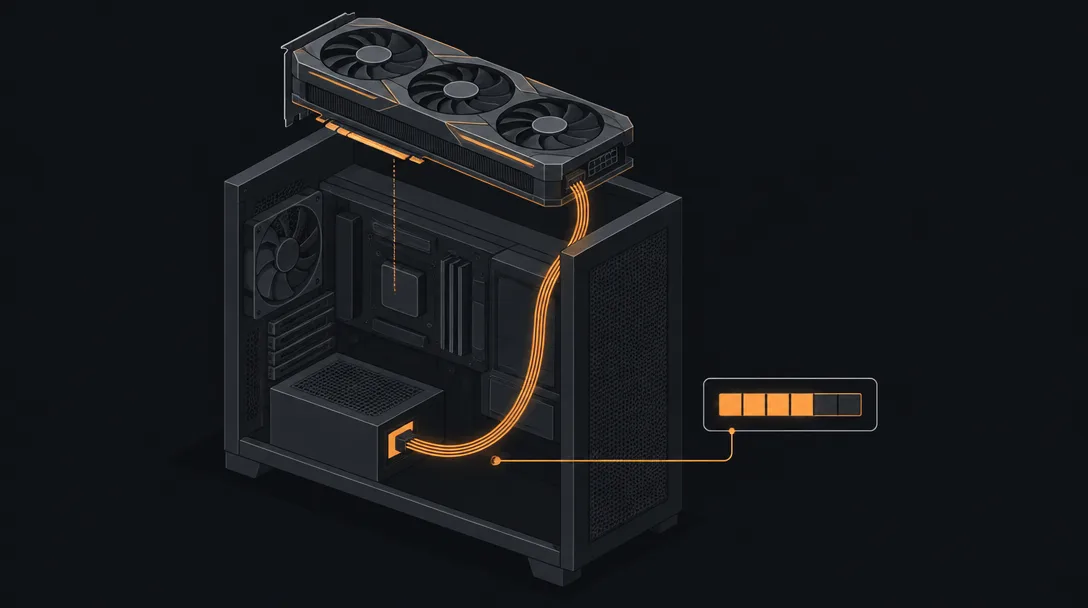 GPUだけ買い替えるときの電源容量 — RTX 50シリーズの推奨電源・補助電源コネクタ・ケース長の確認手順
グラボ交換で先に確認するのは電源容量・補助電源コネクタ・カード長の3点。RTX 5060〜5090のNVIDIA公称「必要なシステム電力」とコネクタ、12V-2x6とATX 3.xの公式情報を整理し、GPU換装か本体買い替えかの判断軸をまとめる。
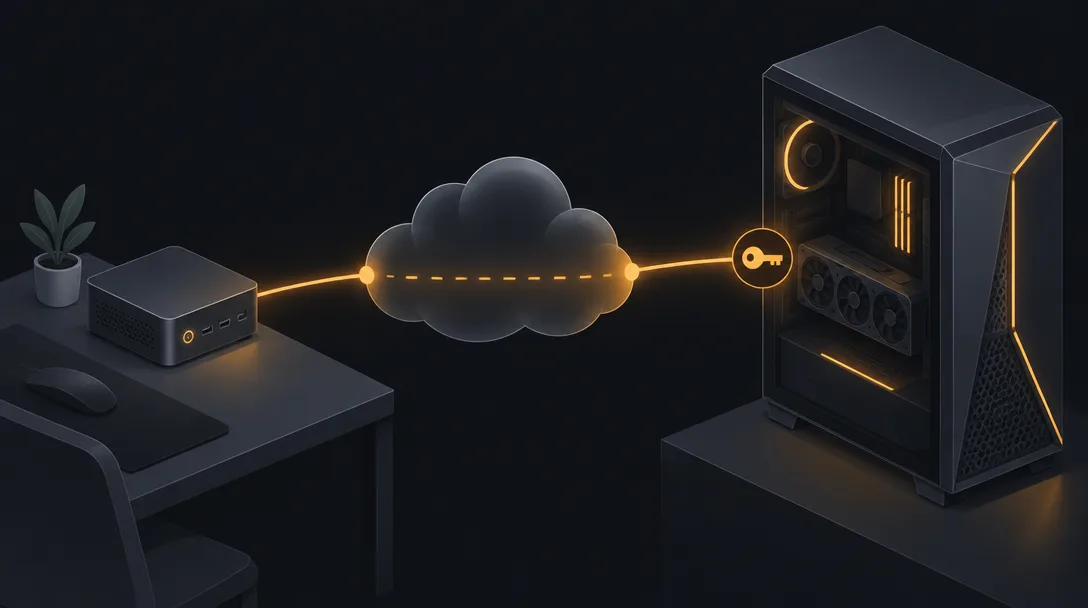 Mac miniを司令塔、WindowsゲーミングPCを重機にする — TailscaleとSSHで作るハイブリッド開発環境の設計図
手元は軽いMac、GPUはWindows。Tailscaleの私設VPNとOpenSSHの公開鍵認証で2台をつなぐ設計図を、Tailscale・Microsoft Learn・VS Codeの公式手順にあるコマンドだけで組む。WSL2に入る経路と落とし穴も。
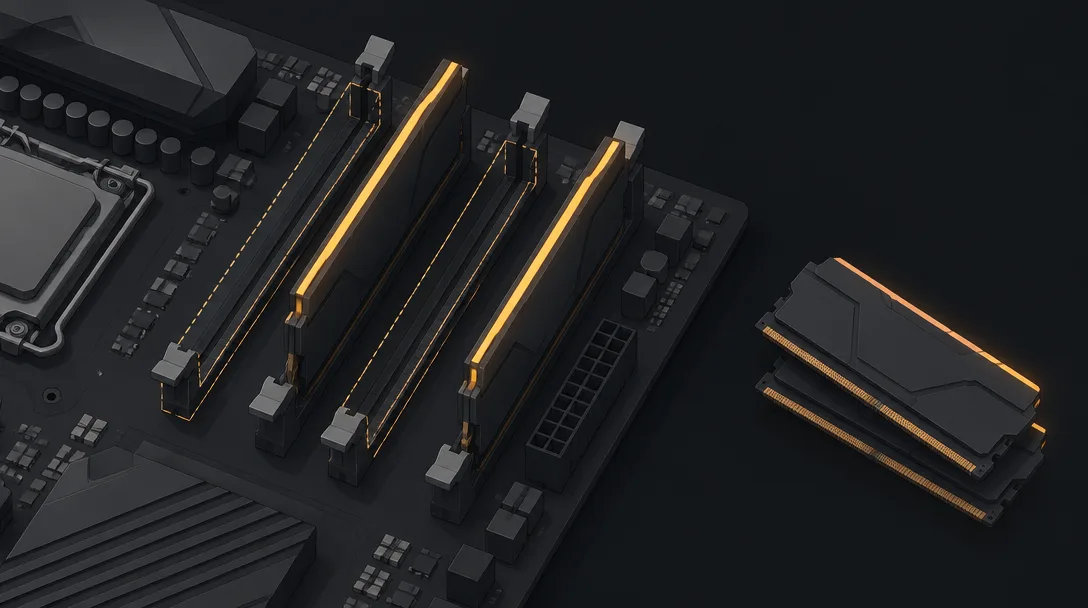 ゲーミングPCのメモリ増設 — DDR5の規格・空きスロット・最大容量の見方と、AI開発で64GB/128GBが効く場面
ゲーミングPCのメモリ増設で失敗しないために、DDR4とDDR5の違い、空きスロット・最大容量・デュアルチャネルの読み方をIntel/AMD/Corsair/ASUSの公式資料から整理。AI開発で64GB・128GBが効く場面と、増設時の注意点も。
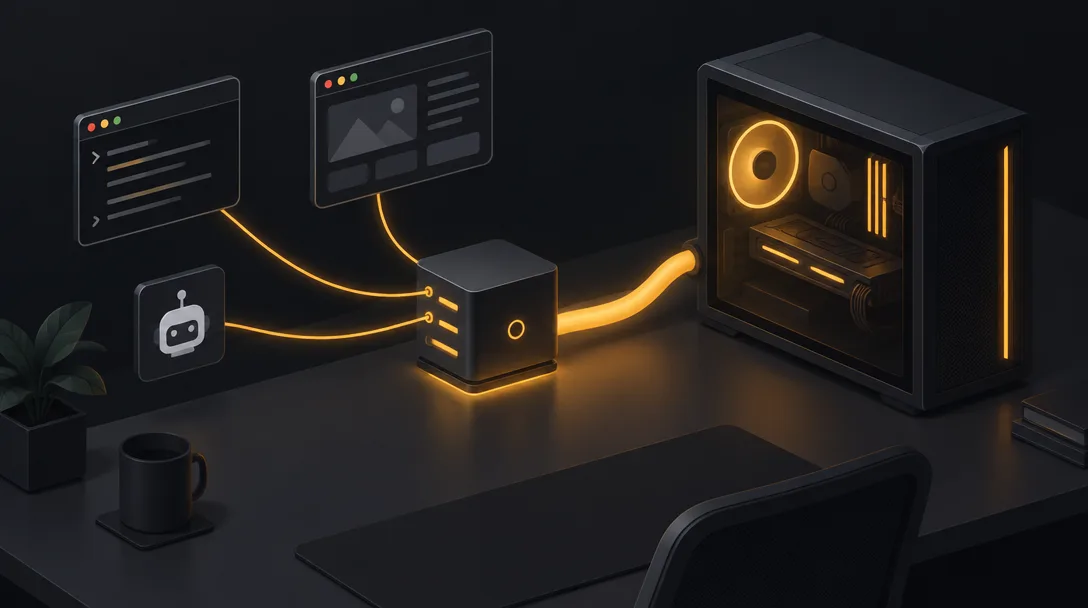 OllamaでローカルLLMを動かす手順 — WindowsゲーミングPC(WSL2/ネイティブ)で最初の1モデルを走らせるまで
OllamaはWindowsにインストールして「ollama run llama3.1」と打てば最初のローカルLLMが動く。ネイティブ版とWSL2の2ルート、pull/ps/rmなど公式コマンド、サーバー構成の図解、公式FAQにある詰まりどころを整理する。
 BTOショップ10社を「保証・送料・納期・カスタマイズ・セール周期」で比較 — AI開発もやる人のショップ選び
FRONTIER・サイコム・マウス・パソコン工房・ドスパラなど10社のBTOショップを、公式記載の保証・送料・納期・カスタマイズ自由度・セール周期で横並び比較。AI開発視点でメモリ上限・電源・VRAM 12GB以上構成の見方も整理する。
 画像生成AIに必要なVRAMはいくつ? SD1.5 / SDXL / FLUX.1 / 動画生成をモデル別に整理
SD1.5・SDXL・FLUX.1・Wan2.xの動画生成まで、公式ドキュメントの推奨VRAMだけを表で整理。8GB/12GB/16GBで何が回るか、fp8やオフロードの逃げ道、Radeonの注意点も公式の範囲でまとめた。
 ローカルLLMを動かすPCスペック — VRAM別「載るモデル」早見表と、メインRAMで補う方法
ローカルLLM(Ollama / llama.cpp)を動かすPCスペックはVRAM容量でほぼ決まる。パラメータ数×ビット数の計算式、8〜32GBのVRAM別に載るモデル規模の目安、メインRAMへのオフロードを公式ドキュメント基準で整理する。
 RTX 5060 vs RTX 5070 — 8GBと12GB、ゲーム×AI開発の二刀流ならどっち? VRAM視点で比較
RTX 5060(VRAM 8GB)とRTX 5070(12GB)をNVIDIA公式スペックと公表データからVRAM視点で比較。ゲーム特化なら5060で成立、AIも混ぜるなら12GBが最低ライン。BTO実売の差額約7万円と5060 Ti 16GBの注意点も整理。
 ゲーミングPC初心者の選び方 — AI開発もやるなら、見る順番は「GPU→メモリ→CPU」
初めてのゲーミングPC選びで、AI開発・ローカルLLMも視野に入れるなら優先順位が変わる。VRAM容量→メインメモリ→CPUの順に見るべき理由と、予算別の考え方を施工管理の段取り思考で整理する。
 MiniMax M3がオープンウェイトで来た。428BはゲーミングPCで動くのか、正直に計算してみる
2026年6月公開のMiniMax M3(総428B・アクティブ23BのMoE、1Mコンテキスト)はローカルで動かせるのか。量子化後のサイズを概算し、ゲーミングPCで現実的に狙える構成(VRAMよりメインRAM)を整理する。
 VRAMとは何か — ゲームとAIで「足りない」の意味がまったく違う話
VRAM(ビデオメモリ)の役割をゲーム用途とAI用途で比較。ゲームは「画質を下げれば動く」、AIは「載らなければ動かない」。この違いがGPU選びをどう変えるかを解説する。
 用途別・BTOパソコン構成の考え方 — ゲーム特化/AI開発/二刀流の3プラン
BTOパソコンをゲーム特化・AI開発特化・兼用(二刀流)の3用途に分けて、GPU(VRAM)・メモリ・電源の優先配分を整理。カスタマイズ画面でどこに予算を寄せるべきかの判断基準を解説する。
 AI開発GPU選び — RTX 5070 vs RTX 5070 Ti、VRAM視点で徹底比較
RTX 5070(VRAM 12GB)と RTX 5070 Ti(VRAM 16GB)をAI開発・画像生成・LLM推論の観点で徹底比較。手取り19万の視点から、どちらを買うべきか結論を出す。
 開発はMac、火力はWindows。手取り19万の二刀流で「AI×ゲーム開発」に挑む理由
Mac(司令塔)× ゲーミングPC(重機)。5年落ちMacBook ProとRTX 2070Sの二刀流で、手取り19万の施工管理技士がAI×ゲーム開発に挑む宣言。
 WSL2 + CUDA で始めるAI開発環境セットアップ完全ガイド
WindowsゲーミングPC上でWSL2+CUDAを使ったAI開発環境を構築する完全ガイド。Python、PyTorch、Stable Diffusionまで一気にセットアップ。
 このブログの構築ログ — Antigravityで作り、Claude Code × Astroへ移した記録
lovegamingpcs.comはAIエージェント「Antigravity」とNext.js・Sanity・Vercelで作り、2026年8月にAstroの静的サイトへ移した。今の構成と運用の流れ、移行で変わったことを記録する。