7年前のLEVEL∞(i7-9700K/RTX 2070 SUPER/メモリ16GB)でローカルAIはどこまで動くか — 実測5本の総まとめと買い替え判断
パソコン工房のBTO・LEVEL∞(RTX 2070 SUPER 8GB)で測った5本の実測をまとめた。SDXLは2048まで完走、qwen3 8Bは66.82トークン/秒。崩れたのは14B以上のLLMだけで、買い替えの判断軸はVRAM 8GBの枠に絞られた。
7年前のLEVEL∞でも、SDXLは2048×2048まで完走し、qwen3 8Bは66.82トークン/秒で動いた。崩れたのは14B以上のLLMだけで、7.6トークン/秒まで落ちた。買い替えの判断軸は、VRAM 8GBの枠の1点に絞られる。
俺の手元の重機は、パソコン工房のBTO「LEVEL∞」だ。CPUはi7-9700K、GPUはRTX 2070 SUPER、メモリは16GB。BIOSの日付は2019年8月30日で、そこから7年たった。
この1台で、2026年9月から10月にかけて画像生成・ローカルLLM・ディスクの読み込みを5本測った。この記事はその総まとめだ。どれも1台・1条件の測定で、環境が違えば結果は変わる。
機材と、測った5本
i7-9700KはIntelの公称で8コア8スレッド、発売はQ4’18、対応メモリはDDR4-2666、PCI Expressは3.0だ(出典: Intel Core i7-9700K 仕様)。RTX 2070 SUPERは公称8GB GDDR6・256-bitのTuring世代(出典: NVIDIA GeForce RTX 20シリーズ比較)。
| 部位 | 手元のLEVEL∞ |
|---|---|
| CPU | Intel Core i7-9700K(8コア8スレッド) |
| マザーボード | Z390-S01(Intel Z390) |
| GPU | RTX 2070 SUPER(VRAM 8GB)・NVIDIAドライバー 617.14 |
| メモリ | DDR4-2666 8GB×2=16GB(4スロット中2スロット空き) |
| ストレージ | NVMe SSD 512GB / SATA SSD 1TB / SATA SSD 2TB / HDD 2TB |
| OS | Windows 11 Home |
測った5本は次のとおりだ。各記事に条件と生の数値を載せている。
| 測ったこと | 測定日 | 記事 |
|---|---|---|
| SDXLを8GBで、解像度・枚数・モード別に | 2026年9月28日 | VRAM 8GBでSDXLはどこまで動くか |
| qwen3 8B/14B/32BがVRAMからあふれたとき | 2026年9月28日 | OllamaのモデルがVRAMからあふれると何が起きるか |
| 同じLLMをMac mini M4 Proと比べる | 2026年9月28日 | Mac mini M4 ProとRTX 2070 SUPER、同じローカルLLMはどちらが速いか |
| モデル置き場のディスクで読み込みは変わるか | 2026年9月28日 | モデル置き場で読み込み時間は変わるか |
| LM StudioとOllamaの速さ | 2026年10月20日 | LM StudioとOllama、同じモデルファイルなら速さはどれだけ違うか |
全体像。8GBの枠に収まるかで、明暗が分かれた
5本を並べると、結果を大きく分けたのはVRAM 8GBの枠だった。ディスクは読み込みの待ち時間を変えたが、生成の速さは変えなかった。CPUを替えた比較はしていない。
現場でいえば、搬入口の幅で入る資材が決まる。入る資材なら7年前の重機でも普通に回る。入らない資材は、外に仮置きして往復するので、急に段取りが崩れる。
画像生成。SDXLは2048×2048まで完走した
ComfyUI 0.37.0でSDXL base(6.94GB)を、既定・--lowvram・fp8の3モードで測った。12条件すべてが完走し、VRAM不足のエラーは0件だった。
| 条件(既定モード) | 時間 | VRAM最大(nvidia-smi) |
|---|---|---|
| 1024×1024・1枚 | 18.32秒 | 7,811MiB |
| 1024×1024・4枚 | 56.82秒 | 7,310MiB |
| 1536×1536・1枚 | 45.92秒 | 7,902MiB |
| 2048×2048・1枚 | 135.82秒 | 7,886MiB |
--lowvram を付けても、1024×1024・1枚は17.97秒で、既定とほぼ同じだった。fp8も1024×1024・1枚では14.94秒と最速だったが、2048では144.57秒と既定より遅い。各1回の測定なので、fp8が速いとは言えない。
8GBで「動く」ことと「使える絵になる」ことは別だった。一方で、SDXLの標準に近い1024×1024なら1枚18.32秒で出ている。
ローカルLLM。8Bは実用、14Bから段が落ちる
Ollama 0.34.4でqwen3(q4_K_M)の3サイズを測った。
| モデル | 読み込み時のsize | VRAM側 | 生成速度(中央値) |
|---|---|---|---|
| qwen3 8B | 5.58GB | 100% | 66.82 tok/s |
| qwen3 14B | 10.15GB | 63% | 7.6 tok/s |
| qwen3 32B | 21.56GB | 29% | 0.02 tok/s(1回・32トークン) |
8Bは全部VRAMに載り、66.82トークン/秒だった。14Bは37%があふれて7.6トークン/秒。32Bは32トークンを書くのに全体で1,818.03秒かかった。
8Bはツールを替えても大差なかった。同じGGUFファイルをLM Studioにも読ませて5回ずつ測ると、Ollamaが67.54、LM Studioが64.58トークン/秒。差は約4.4%で、どちらも60トークン/秒台だった。
手元のモデルがVRAMに収まっているかは、ollama ps のPROCESSOR欄で分かる。「100% GPU」なら全部GPU、「48%/52% CPU/GPU」のような表示なら両方に分かれている、と公式FAQにある(出典: Ollama FAQ)。
同じLLMをMac miniで走らせると
14Bで遅くなる理由がVRAMの枠なら、枠の広い機械では落ちないはずだ。ユニファイドメモリ24GBのMac mini M4 Proで、同じモデル・同じ設定を測った。
| モデル | LEVEL∞(2070 SUPER) | Mac mini M4 Pro(24GB) |
|---|---|---|
| qwen3 8B | 66.82 tok/s | 43.88 tok/s |
| qwen3 14B | 7.6 tok/s | 24.97 tok/s |
| qwen3 32B | 0.02 tok/s | 0.07 tok/s |
8Bでは7年前のLEVEL∞のほうが速い。14BではMacが逆転した。Macは14Bも全部GPU側に載ったままだった。
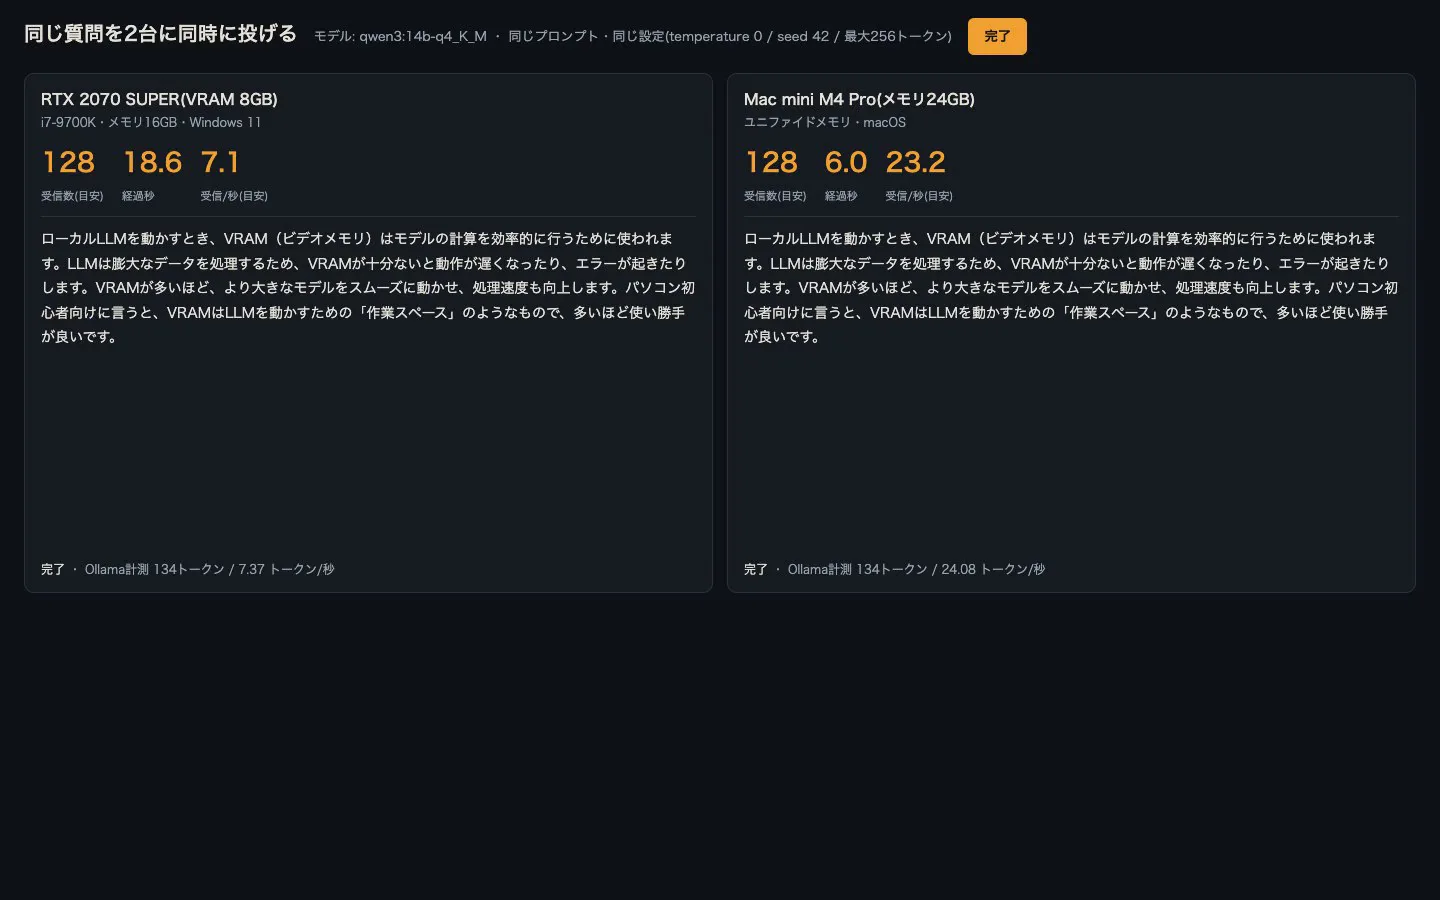
32Bは、24GBのMacでも0.07トークン/秒だった。32Bをこの2台で使う道は、測った範囲では無い。
ディスク。変わるのは読み込みの待ち時間だけ
同じSDXLのファイル(6,938,078,334バイト)を4台のディスクに置き、Windowsのファイルキャッシュを空にしてからComfyUIで1枚目と2枚目を測った。
| ディスク | ファイルを読む速さ(3回平均) | 1枚目(読み込み込み) | 2枚目(読み込み済み) |
|---|---|---|---|
| NVMe SSD(Intel 660p 512GB) | 約1039MB/s | 22.45秒 | 18.06秒 |
| SATA SSD(Samsung 860 QVO 1TB) | 約454MB/s | 34.85秒 | 16.71秒 |
| SATA SSD(Crucial BX500 2TB) | 約478MB/s | 33.45秒 | 17.73秒 |
| HDD(Seagate BarraCuda 2TB) | 約166MB/s | 69.92秒 | 17.73秒 |
1枚目はHDDで69.92秒、NVMeで22.45秒。2枚目はどのディスクでも16.71〜18.06秒に収まった。読み込みが済めば、置き場は生成の速さに効いていない。
ComfyUIの起動ログには、置き場ごとの判定が残っていた。
[INFO] Model storage policy: fast_disk=True paths=['C:\\AI-Bench-tmp\\sd_xl_base_1.0.safetensors']
[INFO] Model storage policy: fast_disk=False paths=['F:\\AI-Bench-tmp\\sd_xl_base_1.0.safetensors']
[INFO] Model storage policy: fast_disk=False paths=['G:\\AI\\Bench\\models\\checkpoints\\sd_xl_base_1.0.safetensors']
[INFO] Model storage policy: fast_disk=False paths=['D:\\AI-Bench-tmp\\sd_xl_base_1.0.safetensors']
NVMeだけが fast_disk=True と判定された。ComfyUI v0.37.0のリリースノートには、ディスクが速いときに --fast-disk を自動で有効にする旨の項目がある(出典: ComfyUI v0.37.0 リリースノート)。
買い替え判断。外せないのはVRAMの枠1点
5本の結果から、このLEVEL∞の限界はこう整理できる。
- SDXLの1024×1024は1枚18.32秒、VRAMに全部載るqwen3 8Bは66.82トークン/秒で動いた
- 14B以上のLLMは、VRAM 8GBからあふれた時点で7.6トークン/秒、32Bでは0.02トークン/秒まで落ちた
- ディスクを速くして縮むのは最初の読み込み待ちで、生成の速さは変わらなかった
- ツールをOllamaからLM Studioに替えても、8Bの差は約4.4%だった
つまり、今の使い方が「SDXLで1024前後の画像」と「8Bクラスの会話」で足りているなら、この機械はまだ現役で回る。ComfyUIのSDXLでは、モデルをNVMeに置くと1枚目の待ちがHDDの69.92秒から22.45秒に縮んだ。Ollamaで同じ比較はしていない。
逆に、14B以上をGPUの速さで回したいなら、ディスクやツールをいじっても枠は広がらない。VRAMの大きいGPUへ替えるか、ユニファイドメモリの大きい機械に回すか、という話になる。メモリ16GBの空き2スロットに増設した場合の速さは、今回測っていない。
買い替える場合の見比べ方は、現行のLEVEL∞を公式情報から読んだパソコン工房(LEVEL∞)をAI開発目線で読むと、VRAM別の目安のローカルLLMのPCスペック早見表にまとめてある。いま売っている機種は、今週のセール機をVRAM基準で仕分けた表と二刀流ランキングで、VRAMの容量から先に見てほしい。
最強の1台より、載せたいモデルがVRAMに全部入る1台。7年前の機械が教えてくれた外せない1点は、それだけだった。
※本記事は公開情報と筆者の手元環境(パソコン工房 LEVEL∞・RTX 2070 SUPER機とMac mini M4 Proの各1台・2026年9月28日と10月20日)での測定に基づく解説です。各条件1回または数回の測定で、ドライバー・ソフトの版・常駐アプリ・空きメモリ・ディスクの状態で結果は変わります。メモリ増設・GPU交換後の速さ、FLUX、NVMe Gen4/Gen5は検証していません。最新の仕様は各公式ドキュメントをご確認ください。
出典
- Intel Core i7-9700K 仕様(8コア8スレッド・発売Q4’18・DDR4-2666・PCI Express 3.0): https://www.intel.com/content/www/us/en/products/sku/186604/intel-core-i79700k-processor-12m-cache-up-to-4-90-ghz/specifications.html
- NVIDIA GeForce RTX 20シリーズ比較(RTX 2070 SUPER 8GB GDDR6・256-bit・Turing): https://www.nvidia.com/en-us/geforce/graphics-cards/compare/?section=compare-20
- Ollama FAQ(ollama psのPROCESSOR表示): https://docs.ollama.com/faq
- Ollama API generate(eval_count・eval_duration): https://docs.ollama.com/api/generate
- ComfyUI v0.37.0 リリースノート(–fast-diskの自動有効化): https://github.com/comfyanonymous/ComfyUI/releases/tag/v0.37.0
- Apple Mac mini (2024) 技術仕様(M4 Pro・ユニファイドメモリ24GB): https://support.apple.com/en-us/121555